
Giới thiệu về Trình Dịch Mã DNA – RNA – Protein
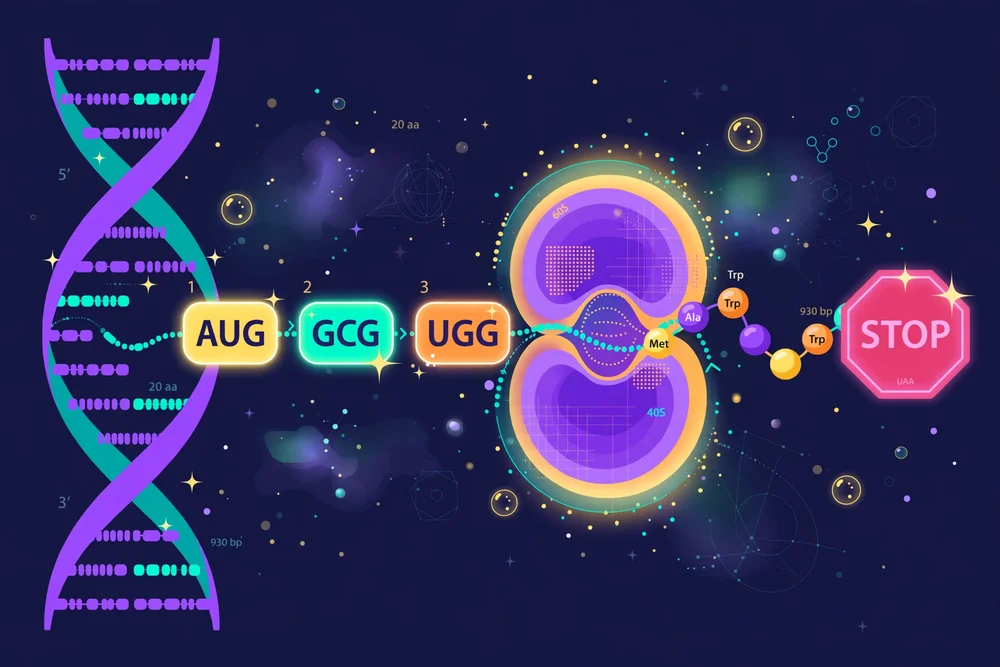
Trình Dịch Mã DNA – RNA – Protein là công cụ web mô phỏng việc chuyển một trình tự nucleotide thành mARN và tra cứu chuỗi axit amin tương ứng. Công cụ hỗ trợ ba loại đầu vào: mạch khuôn ADN, mạch mã hóa ADN và mARN, giúp người dùng quan sát mối liên hệ giữa thông tin di truyền và sản phẩm dịch mã trên cùng một giao diện.
Trong bài tập sinh học phân tử, một lỗi nhỏ như nhầm mạch khuôn với mạch mã hóa, thay sai nucleotide hoặc chia lệch bộ ba có thể làm thay đổi toàn bộ kết quả. Công cụ tự động hóa những thao tác này: xác định mARN, chia trình tự thành codon, đối chiếu bảng mã di truyền và dừng chuỗi khi gặp codon kết thúc.
Kết quả được thể hiện bằng các bộ ba riêng biệt và các mắt xích axit amin, với màu sắc phân biệt AUG và các mã STOP. Cách trình bày này phù hợp để học, kiểm tra bài tập và minh họa nguyên lý phiên mã – dịch mã. Tuy nhiên, cần hiểu đúng phạm vi: công cụ tra mã từ nucleotide đầu tiên của chuỗi nhập, không tự tìm vùng mã hóa bắt đầu tại AUG và không mô phỏng đầy đủ quá trình tổng hợp protein trong tế bào. Xem thêm các công cụ khác trong danh mục Sinh học để giải các bài tập di truyền khác.
Giải thích các thuật ngữ và thông số
Loại mạch đầu vào
Đây là thông số quyết định cách tạo trình tự mARN. Có ba giá trị lựa chọn:
- Mạch khuôn ADN (3′ → 5′): trình tự được hiểu là đang viết theo chiều 3′ đến 5′. Công cụ tạo mARN theo nguyên tắc bổ sung A → U, T → A, G → C và C → G. Kết quả được đọc theo chiều 5′ → 3′. Đây là lựa chọn mặc định.
- Mạch mã hóa ADN (5′ → 3′): mARN có trình tự tương ứng với mạch này, nhưng T được thay bằng U. Không thực hiện phép bổ sung từng nucleotide.
- mARN (5′ → 3′): đầu vào được dùng trực tiếp để chia codon và tra axit amin. Nếu có T, công cụ chuyển T thành U.
Các ký hiệu 3′ và 5′ chỉ chiều của mạch axit nucleic, liên quan đến vị trí carbon trong đường pentose; đây không phải đơn vị đo độ dài. Công cụ không tự đảo chiều trình tự, nên chiều đầu vào phải phù hợp với loại mạch đã chọn.
Trình tự nucleotide
Ô nhập nhận chuỗi ký tự biểu diễn các nucleotide. Về sinh học, ADN sử dụng A, T, G, C, còn ARN sử dụng A, U, G, C. Nếu cần tính nhanh các thông số của phân tử ADN từ trình tự đang xét, bạn có thể dùng máy tính thông số cấu trúc ADN.
- A: adenine.
- T: thymine, thuộc bảng chữ cái của ADN.
- G: guanine.
- C: cytosine.
- U: uracil, thuộc bảng chữ cái của ARN.
Ô nhập chấp nhận A, T, G, C ở chế độ ADN và A, U, G, C ở chế độ mARN, cùng khoảng trắng. Chữ thường được chuyển thành chữ hoa; dòng bắt đầu bằng dấu > được hiểu là tiêu đề FASTA và bỏ qua. Khi xử lý, toàn bộ khoảng trắng, kể cả xuống dòng, được xóa. Ký tự ngoài bảng chữ cái của chế độ đã chọn (ví dụ N, hoặc U ở chế độ ADN) không còn bị loại âm thầm: công cụ báo rõ ký tự đó và ẩn kết quả cho tới khi chuỗi được sửa.
Phạm vi ký tự được giao diện chấp nhận không đồng nghĩa với tính hợp lệ sinh học. Chẳng hạn, U không được chấp nhận ở chế độ ADN và sẽ bị báo lỗi, dù công cụ vẫn đổi T thành U ở chế độ mARN. Các ký hiệu nucleotide chưa xác định như N cũng không được hỗ trợ và sẽ bị báo lỗi thay vì bị xóa âm thầm.
Độ dài trình tự được tính bằng nucleotide, viết tắt là nt. Mã nguồn không đặt giới hạn chiều dài cụ thể. Chuỗi rỗng sau khi loại khoảng trắng không được xử lý; chuỗi có một hoặc hai nucleotide chưa đủ tạo một axit amin.
Trình tự mARN đầu ra
Đây là chuỗi RNA sau bước chuyển đổi, được hiển thị theo chiều 5′ → 3′. Với đầu vào mARN, phần kết quả này chủ yếu thể hiện lại chuỗi đã chuẩn hóa, chứ không có thêm một bước phiên mã thực sự.
Trong các phép chuyển đổi của công cụ, mỗi nucleotide đầu vào tạo ra một nucleotide đầu ra, nên chiều dài mARN bằng chiều dài trình tự đã loại khoảng trắng.
Codon và khung đọc
Codon là một bộ ba nucleotide trên mARN. Mỗi codon hoàn chỉnh dài 3 nt và được đối chiếu với bảng mã di truyền gồm 64 bộ ba.
Công cụ cố định khung đọc tại nucleotide đầu tiên: vị trí 1–3 tạo codon thứ nhất, vị trí 4–6 tạo codon thứ hai và tiếp tục như vậy. Các khoảng trắng do người dùng đặt không quyết định ranh giới codon.
Nếu độ dài không chia hết cho 3, nhóm một hoặc hai nucleotide ở cuối vẫn xuất hiện trong phần mARN nhưng không được chuyển thành axit amin.
Chuỗi polypeptide và ký hiệu axit amin
Đầu ra dịch mã dùng mã viết tắt ba chữ cái, chẳng hạn Met là methionine, Ala là alanine, Arg là arginine, Leu là leucine và Trp là tryptophan. Độ dài chuỗi được tính bằng số gốc axit amin, không phải số nucleotide.
- Met (Start): nhãn mà công cụ gán cho codon AUG. Mọi AUG trong khung đọc đều được đánh dấu theo cách này, kể cả AUG nằm giữa chuỗi.
- STOP: nhãn dành cho UAA, UAG hoặc UGA. Công cụ hiển thị nhãn rồi ngừng tạo các mắt xích tiếp theo.
STOP không phải axit amin, nên không được tính vào độ dài polypeptide. Tương tự, nhãn “Start” trên giao diện không chứng minh rằng AUG đó là vị trí khởi đầu dịch mã thực sự trong một tế bào.
Mục đích và lợi ích
Kiểm tra nhanh bài tập phiên mã và dịch mã
Công cụ giúp đối chiếu chuỗi mARN và axit amin sau khi người học tự giải bài. Việc tách riêng kết quả phiên mã và dịch mã giúp xác định lỗi nằm ở bước chuyển nucleotide, chia bộ ba hay tra bảng mã.
Trong giảng dạy, cùng một thông tin di truyền có thể được biểu diễn dưới dạng mạch khuôn, mạch mã hóa hoặc mARN. So sánh ba dạng đầu vào là cách trực quan để giải thích vì sao mạch mã hóa giống mARN về trình tự, ngoại trừ T được thay bằng U.
Giảm thao tác lặp lại so với tính thủ công
Cách làm thủ công đòi hỏi chuyển từng nucleotide, chia nhóm ba ký tự và tra từng codon. Công cụ thực hiện liên tiếp các bước này, đặc biệt hữu ích khi chuỗi dài hoặc có nhiều codon lặp lại.
- Về tốc độ: các phép chuyển đổi và tra cứu được thực hiện trực tiếp trong trình duyệt, không có bước gửi chuỗi lên máy chủ trong công cụ.
- Về tính nhất quán: cùng một trình tự và loại mạch luôn được xử lý theo cùng một quy tắc.
- Về khả năng kiểm chứng: người dùng có thể đối chiếu từng bộ ba mARN với từng mắt xích axit amin.
Độ chính xác cần được hiểu trong phạm vi bảng mã di truyền chuẩn và khung đọc đã cố định. Công cụ không thay thế việc xác định vùng mã hóa, xử lý intron hoặc phân tích protein trưởng thành. Với bài tập lai giống cần lập bảng tỉ lệ kiểu gen, bạn có thể dùng bảng lai di truyền Punnett.
Các tính năng nổi bật
- Ba chế độ đầu vào: xử lý mạch khuôn ADN, mạch mã hóa ADN và mARN bằng quy tắc riêng.
- Tính trực tiếp và kiểm tra ký tự: kết quả cập nhật ngay khi gõ hoặc đổi chế độ; ký tự ngoài bảng chữ cái của chế độ đã chọn được báo rõ tên và làm ẩn kết quả, thay vì bị loại âm thầm.
- Tự chia codon: gom nucleotide theo từng nhóm ba từ đầu chuỗi, không phụ thuộc cách đặt dấu cách.
- Tra cứu đủ 64 codon: sử dụng bảng mã chuẩn cho 20 loại axit amin và ba mã kết thúc.
- Phân biệt mã đặc biệt bằng màu: AUG được tô xanh lá; UAA, UAG và UGA được tô hồng.
- Dừng tại STOP đầu tiên: phần polypeptide không tiếp tục dịch các codon phía sau mã kết thúc trong khung đọc.
- Giữ toàn bộ mARN trong kết quả: các codon nằm sau STOP vẫn được hiển thị ở phần trình tự mARN để quan sát.
- Xử lý phần dư cuối chuỗi: nhóm dưới ba nucleotide được hiển thị nhưng không tra thành axit amin.
- Có chuỗi mẫu và ví dụ nhanh: nút “Chuỗi mẫu” điền trình tự chứa AUG và STOP, đồng thời chọn chế độ mạch khuôn ADN và tính ngay; các chip ví dụ điền sẵn ba tình huống còn lại trong bài viết.
- Xóa nhanh ô nhập: nút “Xóa trắng” làm rỗng trình tự và ẩn luôn kết quả đã hiển thị trước đó.
- Giao diện thích ứng màn hình nhỏ: các lựa chọn xếp gọn khi chiều rộng màn hình không vượt quá 600 px; các mắt xích axit amin có thể xuống dòng.
Kết quả cập nhật trực tiếp ngay khi gõ hoặc đổi chế độ, kèm thống kê số nucleotide, số codon, số nucleotide dư, số axit amin và vị trí STOP; mỗi codon hiển thị kèm axit amin tương ứng, chuỗi 1 chữ cái và nút sao chép mARN hoặc protein.
Đối tượng sử dụng
- Học sinh học sinh học phổ thông: củng cố kiến thức về nguyên tắc bổ sung, mã di truyền và mối quan hệ ADN – ARN – protein.
- Sinh viên sinh học, công nghệ sinh học, y và dược: kiểm tra các ví dụ cơ bản về trình tự nucleotide và khung đọc.
- Giáo viên, giảng viên: minh họa bài giảng và tạo tình huống so sánh giữa các loại mạch.
- Người tự học sinh học phân tử: khám phá cách thay đổi một nucleotide có thể tác động đến codon và axit amin.
- Người làm nội dung giáo dục khoa học: kiểm tra các chuỗi minh họa trước khi đưa vào tài liệu.
Người mới chỉ cần nắm được A, T, G, C, U và khái niệm bộ ba. Với người dùng chuyên môn, công cụ phù hợp cho tra mã nhanh trên một khung đọc xác định, không phải hệ thống chú giải gene hay công cụ dự đoán protein hoàn chỉnh.
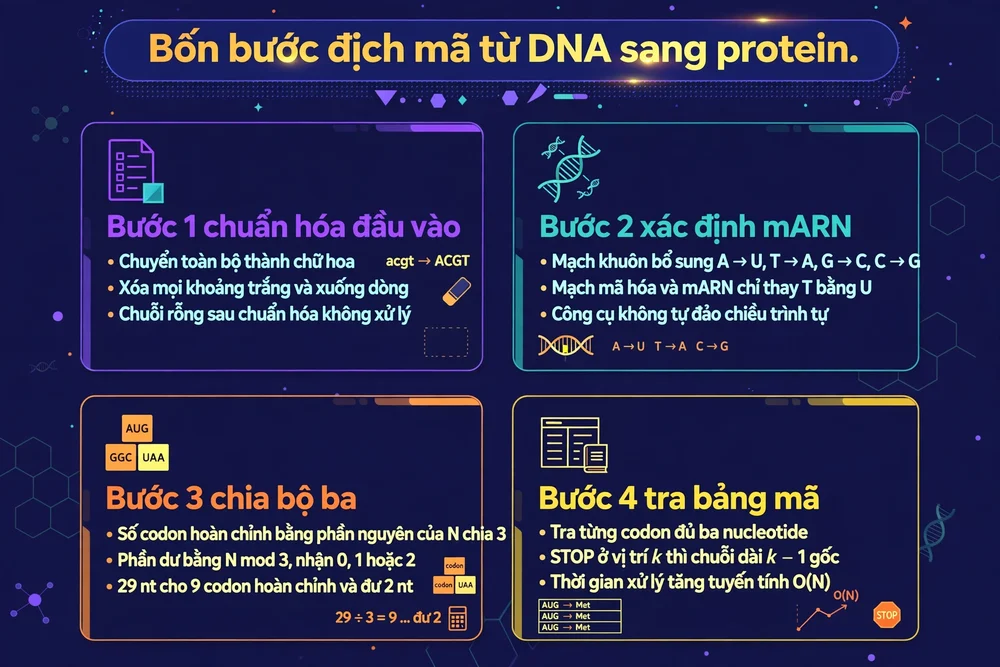
Nguyên lý hoạt động và công thức
Bước 1: Chuẩn hóa đầu vào
Trình tự được chuyển thành chữ hoa và loại toàn bộ khoảng trắng trước khi tính toán. Ví dụ, tac cgc và TACCGC đều trở thành cùng một chuỗi xử lý.
Gọi N là số nucleotide sau chuẩn hóa. Nếu N = 0, quá trình không tạo kết quả mới.
Bước 2: Xác định mARN theo loại mạch
Với mạch khuôn viết theo chiều 3′ → 5′, áp dụng phép bổ sung:
A → U; T → A; G → C; C → G.
Ví dụ: 3′-TAC-5′ → 5′-AUG-3′. Do chiều đầu vào đã được quy định, công cụ không đảo thứ tự ký tự.
Với mạch mã hóa viết theo chiều 5′ → 3′, chỉ thay T → U. Ví dụ: 5′-ATG-3′ → 5′-AUG-3′. Với mARN, chuỗi được giữ nguyên sau chuẩn hóa, ngoại trừ T cũng được đổi thành U.
Bước 3: Chia chuỗi thành bộ ba
Số codon hoàn chỉnh và phần dư được xác định bằng:
- Số codon hoàn chỉnh = ⌊N ÷ 3⌋.
- Số nucleotide dư = N mod 3, nhận giá trị 0, 1 hoặc 2.
Ký hiệu ⌊ ⌋ biểu thị lấy phần nguyên xuống; “mod” là phép lấy số dư. Ví dụ, chuỗi 29 nt có 9 codon hoàn chỉnh và dư 2 nt.
Tất cả các nhóm đều được đưa lên phần mARN. AUG và ba codon STOP được tô màu nếu trùng đúng nhóm đang xét; công cụ không tìm các bộ ba lệch khỏi khung đọc này.
Bước 4: Tra bảng mã và tạo chuỗi axit amin
Mỗi codon đủ ba nucleotide được tra trong bảng mã. Công cụ bắt đầu ngay từ codon thứ nhất, kể cả khi codon đó không phải AUG.
Nếu gặp AUG, công cụ thêm mắt xích “Met (Start)”. Nếu gặp UAA, UAG hoặc UGA, công cụ thêm nhãn STOP và ngừng dịch các codon tiếp theo. Nhóm cuối dưới ba nucleotide được bỏ qua khi tạo polypeptide.
Nếu codon STOP đầu tiên nằm ở vị trí k, tính từ 1, số gốc axit amin được tạo là k − 1. Nếu không có STOP, số gốc axit amin bằng số codon hoàn chỉnh, với giả định chuỗi đã chuyển đổi gồm các nucleotide RNA hợp lệ.
Đây là thuật toán thay thế ký tự và tra bảng, không phải công thức vật lý. Thời gian xử lý tăng xấp xỉ tuyến tính theo chiều dài chuỗi, ký hiệu O(N); dung lượng dữ liệu trung gian và đầu ra cũng tăng theo N.
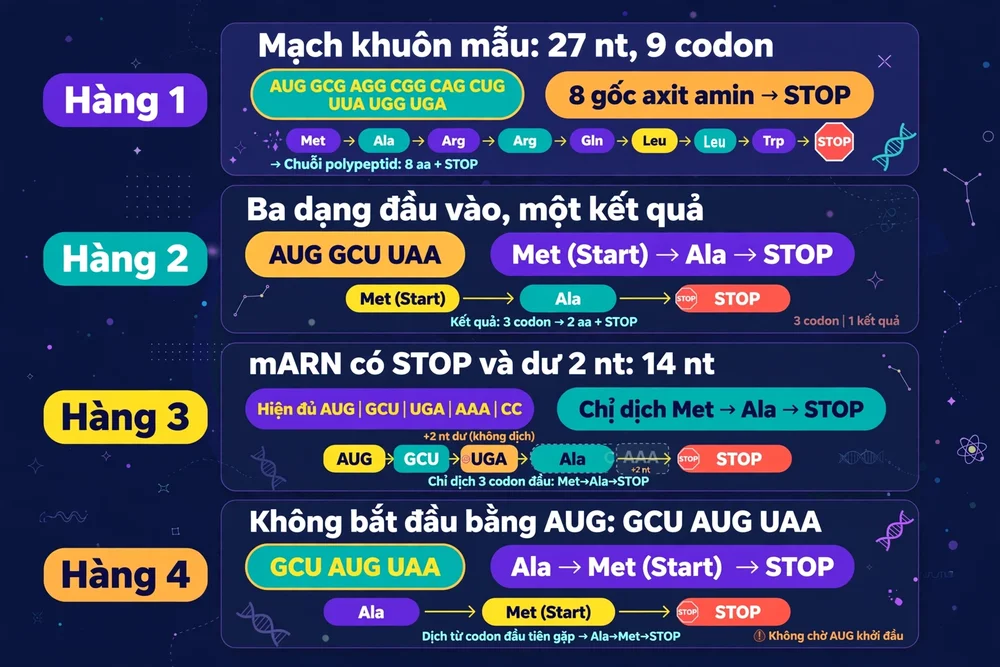
Ví dụ thực tế
Ví dụ 1: Dịch chuỗi mạch khuôn được tích hợp sẵn
Loại đầu vào: mạch khuôn ADN, chiều 3′ → 5′.
Trình tự: TAC CGC TCC GCC GTC GAC AAT ACC ACT
Chuỗi có 27 nucleotide, tạo thành 9 codon hoàn chỉnh. Kết quả chuyển đổi và tra mã là:
| Mạch khuôn ADN | Codon mARN | Kết quả tra mã |
|---|---|---|
| TAC | AUG | Met (Start) |
| CGC | GCG | Ala |
| TCC | AGG | Arg |
| GCC | CGG | Arg |
| GTC | CAG | Gln |
| GAC | CUG | Leu |
| AAT | UUA | Leu |
| ACC | UGG | Trp |
| ACT | UGA | STOP |
mARN: AUG GCG AGG CGG CAG CUG UUA UGG UGA
Đầu ra hiển thị: Met (Start) → Ala → Arg → Arg → Gln → Leu → Leu → Trp → STOP.
Polypeptide có 8 gốc axit amin. Ví dụ này phù hợp để kiểm tra đồng thời phép phiên mã bổ sung và quy tắc không tính STOP vào chiều dài chuỗi.
Ví dụ 2: Cùng một thông tin di truyền dưới ba dạng
- Mạch khuôn ADN:
TAC CGA ATT, chiều 3′ → 5′. - Mạch mã hóa ADN:
ATG GCT TAA, chiều 5′ → 3′. - mARN:
AUG GCU UAA, chiều 5′ → 3′.
Khi mỗi chuỗi được xử lý ở đúng chế độ, cả ba đều cho AUG GCU UAA và đầu ra Met (Start) → Ala → STOP. Đây là tình huống hữu ích để phân biệt hai mạch ADN và kiểm chứng rằng chúng có thể dẫn đến cùng một kết quả dịch mã. Nếu bài tập tiếp theo cho tần số alen của quần thể mang gene này, bạn có thể tính cấu trúc kiểu gen bằng máy tính cân bằng quần thể Hardy-Weinberg.
Ví dụ 3: Chuỗi có STOP và nucleotide dư
Đầu vào mARN: AUG GCU UGA AAA CC.
Chuỗi có 14 nt, gồm 4 codon hoàn chỉnh và 2 nt dư. Phần mARN hiển thị đủ AUG | GCU | UGA | AAA | CC, nhưng phần polypeptide chỉ hiển thị Met (Start) → Ala → STOP.
AAA nằm sau STOP nên không tạo Lys trong đầu ra. CC không đủ ba nucleotide nên không tạo axit amin. Ví dụ cho thấy độ dài trình tự mARN không đồng nghĩa với độ dài phần được dịch.
Ví dụ 4: Chuỗi không bắt đầu bằng AUG
Đầu vào mARN: GCU AUG UAA.
Công cụ trả về Ala → Met (Start) → STOP, vì bắt đầu tra mã từ GCU chứ không bỏ qua nó để tìm AUG. Kết quả này minh họa cách hoạt động của thuật toán, không xác nhận vị trí khởi đầu dịch mã sinh học.
Những thông tin thú vị xung quanh chủ đề này
64 codon không tương ứng với 64 loại axit amin
RNA có bốn loại nucleotide và mỗi codon gồm ba vị trí, nên số tổ hợp là 4³ = 64. Trong bảng mã chuẩn, 61 codon mã hóa axit amin và 3 codon là tín hiệu kết thúc. Nhiều codon có thể cùng mã hóa một axit amin, tạo nên tính thoái hóa của mã di truyền.
Ngay trong chuỗi mẫu, AGG và CGG đều mã hóa Arg; CUG và UUA đều mã hóa Leu. Vì vậy, thay đổi codon không nhất thiết làm thay đổi axit amin.
AUG vừa mã hóa methionine vừa có thể là tín hiệu mở đầu
Vai trò khởi đầu của AUG phụ thuộc vị trí và bối cảnh sinh học. AUG nằm trong vùng đang dịch mã vẫn có thể đơn giản là codon mã hóa methionine. Nhãn “Met (Start)” của công cụ là cách đánh dấu thống nhất cho AUG, không phải kết quả phân tích bối cảnh khởi đầu.
Chỉ một nucleotide thêm hoặc mất có thể đổi hàng loạt codon
Vì trình tự được đọc theo nhóm ba, việc thêm hoặc mất một nucleotide có thể làm dịch chuyển ranh giới của các codon phía sau. Hiện tượng này gọi là đột biến lệch khung đọc và có thể thay đổi nhiều axit amin hoặc tạo STOP sớm.
Chuỗi axit amin chưa phải toàn bộ câu chuyện về protein
Protein có thể phải gấp cuộn, cắt bỏ một số đoạn và trải qua biến đổi sau dịch mã mới đạt dạng hoạt động. Công cụ thể hiện trình tự axit amin theo bảng mã, không dự đoán cấu trúc ba chiều hay chức năng của protein.
Những câu hỏi thường gặp
Công cụ có tự tìm AUG để bắt đầu dịch mã không?
Không. Công cụ chia bộ ba từ nucleotide đầu tiên và tra mã ngay từ bộ ba đó. AUG được đánh dấu “Met (Start)” khi xuất hiện đúng trong khung đọc đang xét.
Mạch khuôn ADN có được tự đảo chiều không?
Không. Chế độ mạch khuôn giả định chuỗi đã được viết theo chiều 3′ → 5′. Công cụ chỉ thay từng nucleotide bằng nucleotide bổ sung để tạo mARN 5′ → 3′.
Nếu chiều dài chuỗi không chia hết cho 3 thì sao?
Một hoặc hai nucleotide dư vẫn xuất hiện ở phần mARN nhưng bị bỏ qua khi tạo chuỗi axit amin. Nếu toàn bộ đầu vào chỉ dài một hoặc hai nucleotide, công cụ hiển thị thông báo không tạo được axit amin.
Tại sao codon sau STOP vẫn xuất hiện trong phần mARN?
Phần mARN hiển thị toàn bộ trình tự đã chuyển đổi. Quy tắc dừng tại STOP chỉ áp dụng cho phần tạo chuỗi polypeptide, không cắt ngắn phần mARN.
STOP có được tính là một axit amin không?
Không. STOP là tín hiệu kết thúc. Khi đếm chiều dài polypeptide, chỉ tính các gốc axit amin trước STOP.
Có thể nhập chữ thường, xuống dòng hoặc chia nhóm bằng dấu cách không?
Có. Chữ thường được chuyển thành chữ hoa; khoảng trắng và xuống dòng được loại trước khi xử lý. Công cụ vẫn chia codon lại từ đầu chuỗi, không dựa trên cách nhóm của người dùng.
Công cụ có hỗ trợ N hoặc ký hiệu nucleotide chưa xác định không?
Không. Công cụ báo rõ ký tự không hợp lệ (ví dụ N) và ẩn kết quả cho tới khi chuỗi được sửa, thay vì xóa âm thầm làm thay đổi chiều dài và khung đọc so với dữ liệu ban đầu.
Công cụ có dùng được cho mọi bảng mã di truyền không?
Công cụ sử dụng bảng mã di truyền chuẩn được tích hợp. Một số hệ sinh học, chẳng hạn một số loại ty thể, sử dụng biến thể của bảng mã; kết quả từ công cụ không tự điều chỉnh theo các biến thể đó.
Kết quả có phải là protein hoàn chỉnh của một gene không?
Không nhất thiết. Công cụ không xác định exon, loại intron, tìm vùng mã hóa hay mô phỏng biến đổi sau dịch mã. Kết quả là chuỗi axit amin suy ra từ đầu vào, theo khung đọc bắt đầu tại nucleotide đầu tiên và dừng tại STOP đầu tiên trong khung đó. Mọi thao tác trên đều chạy miễn phí ngay trên công cụ việt, không cần cài đặt thêm.
Tài liệu tham khảo
- Genetic code — Wikipedia. Bảng mã chuẩn gồm 64 codon: 61 codon mã hóa 20 axit amin chuẩn và 3 codon kết thúc UAA, UAG, UGA; AUG là codon khởi đầu phổ biến nhất, đọc thành methionine; một số ty thể dùng biến thể của bảng mã.
- Transcription (biology) — Wikipedia. Mạch khuôn (antisense) được đọc theo chiều 3′ → 5′, mARN bổ sung được tạo theo chiều 5′ → 3′ và giống mạch mã hóa (sense), chỉ khác U thay cho T.
- Translation (biology) — Wikipedia. Ribosome đọc mARN theo từng bộ ba, mỗi codon cho một axit amin; chuỗi polypeptide sau đó gấp cuộn thành protein hoạt động; quá trình kết thúc khi gặp codon kết thúc.
- Mã nguồn công cụ Trình Dịch Mã DNA – RNA – Protein (sequence-translator-v2) trên congcuviet.com. Đối chiếu bảng mã 64 codon đã triển khai (khớp hoàn toàn bảng mã chuẩn), quy tắc bổ sung mạch khuôn, chia khung đọc cố định từ nucleotide đầu tiên và dừng tại STOP đầu tiên.


