


Giới thiệu về Bảng Tra Cứu Mã Di Truyền Tương Tác
Bảng Tra Cứu Mã Di Truyền Tương Tác là công cụ web giúp xác định axit amin tương ứng với một bộ ba nucleotide trên RNA, đồng thời tìm ngược tất cả bộ ba mã hóa cho một axit amin. Công cụ sử dụng bảng mã di truyền chuẩn gồm 64 codon, bao quát 20 axit amin phổ biến trong tổng hợp protein và ba bộ ba kết thúc.
Thay vì chỉ hiển thị một bảng tĩnh, công cụ kết hợp bảng tổng hợp có thể tương tác với hai hình thức tra cứu: codon → axit amin và axit amin → các codon tương ứng. Kết quả còn cung cấp tên đầy đủ và nhóm tính chất hóa học cơ bản của axit amin, giúp người học liên hệ giữa mã di truyền và đặc điểm của đơn phân cấu tạo protein.
Trong học tập, những nhầm lẫn như đọc sai vị trí nucleotide, sử dụng T thay cho U hoặc bỏ sót các bộ ba đồng nghĩa thường dẫn đến kết quả sai. Công cụ giúp giảm thao tác dò bảng, đặc biệt hữu ích khi cần đối chiếu nhiều codon hoặc kiểm tra tính thoái hóa của mã di truyền.
Phạm vi của công cụ là tra cứu từng bộ ba theo mã di truyền chuẩn, không phải mô phỏng toàn bộ quá trình dịch mã hay phân tích một trình tự gene hoàn chỉnh.
Giải thích các thuật ngữ và thông số
Codon và ba vị trí nucleotide: Nu 1, Nu 2, Nu 3
Codon là một bộ ba nucleotide trên RNA thông tin, được đọc theo chiều 5′ → 3′. Ba trường đầu vào xác định lần lượt nucleotide thứ nhất, thứ hai và thứ ba của bộ ba.
| Thông số | Ý nghĩa | Giá trị hợp lệ | Đơn vị |
|---|---|---|---|
| Nu 1 | Nucleotide ở vị trí đầu tiên của codon | U, C, A hoặc G | Không có đơn vị đo |
| Nu 2 | Nucleotide ở vị trí thứ hai của codon | U, C, A hoặc G | Không có đơn vị đo |
| Nu 3 | Nucleotide ở vị trí thứ ba của codon | U, C, A hoặc G | Không có đơn vị đo |
Trong đó, U là uracil, C là cytosine, A là adenine và G là guanine. Đây là các ký hiệu base dùng cho RNA; giao diện không cung cấp T, ký hiệu của thymine trong DNA.
Thứ tự có ý nghĩa quyết định: AUG mã hóa Methionine, trong khi AGU mã hóa Serine. Ba trường lựa chọn đều mặc định ở U, vì vậy tổ hợp ban đầu là UUU.
Axit amin và ký hiệu viết tắt
Đầu vào của tra cứu ngược là một mục trong danh sách axit amin. Mỗi mục gồm tên đầy đủ và ký hiệu ba chữ cái như Ala, Leu hoặc Met. Danh sách thực tế có 21 lựa chọn: 20 axit amin và một mục STOP; STOP không phải axit amin.
| Nhóm hiển thị | Các axit amin trong dữ liệu công cụ | Ý nghĩa khái quát |
|---|---|---|
| Không phân cực | Alanine (Ala), Glycine (Gly), Isoleucine (Ile), Leucine (Leu), Phenylalanine (Phe), Proline (Pro), Tryptophan (Trp), Valine (Val) | Nhóm có mạch bên được xếp vào loại không phân cực trong cách phân loại của công cụ |
| Phân cực | Asparagine (Asn), Cysteine (Cys), Glutamine (Gln), Serine (Ser), Threonine (Thr), Tyrosine (Tyr) | Nhóm có mạch bên phân cực, thường được phân loại là không mang điện ở pH gần sinh lý |
| Axit (-) | Aspartic Acid (Asp), Glutamic Acid (Glu) | Mạch bên có tính axit, thường mang điện tích âm ở pH gần sinh lý |
| Bazơ (+) | Arginine (Arg), Histidine (His), Lysine (Lys) | Mạch bên có tính bazơ; mức độ mang điện phụ thuộc loại axit amin và pH |
| Mã mở đầu / Không phân cực | Methionine (Met) | Được tách thành nhóm hiển thị đặc biệt vì codon AUG gắn với vai trò khởi đầu dịch mã |
| Ngừng dịch mã | STOP | Tín hiệu kết thúc, không đại diện cho một axit amin |
Các nhãn “phân cực”, “axit” và “bazơ” là phân loại định tính, không phải kết quả đo độ tan, pH hay điện tích thực tế. Đặc biệt, Histidine được xếp vào nhóm bazơ nhưng không có nghĩa mạch bên luôn mang điện tích +1 trong mọi điều kiện.
Các trường kết quả
- Bộ ba: chuỗi ba ký tự như UUU, AUG hoặc GGC.
- Tên axit amin: tên đầy đủ theo dữ liệu công cụ, chẳng hạn Phenylalanine hoặc Glycine.
- Ký hiệu axit amin: mã ba chữ cái và mã một chữ cái (ví dụ Phe/F, Leu/L) xuất hiện trong kết quả và danh sách lựa chọn.
- Nhóm tính chất: nhãn phân loại hóa học hoặc nhãn chức năng đặc biệt đối với AUG và STOP.
- Số bộ ba tương ứng: số lượng codon tìm được khi tra cứu ngược; đây là số đếm, không có đơn vị vật lý.
- Danh sách bộ ba: toàn bộ codon tương ứng với mục được chọn, không chỉ một ví dụ đại diện.
Với 20 axit amin, số codon tương ứng nằm trong khoảng 1–6. Riêng mục STOP trả về ba bộ ba kết thúc. Quan hệ giữa đầu vào và đầu ra là nhiều-một: nhiều codon có thể cùng mã hóa một axit amin, nhưng mỗi codon trong bảng chuẩn chỉ được công cụ gán cho một axit amin hoặc tín hiệu STOP.
Mục đích và lợi ích
Giảm thời gian dò bảng và hạn chế nhầm vị trí
Tra cứu thủ công yêu cầu người học xác định đúng hàng, cột và nucleotide thứ ba, sau đó đối chiếu ký hiệu axit amin với tên đầy đủ. Công cụ gộp các bước đối chiếu này vào một kết quả, thuận tiện cho việc kiểm tra bài tập hoặc ôn tập nhanh.
Ô nhập bộ ba chấp nhận cả ký tự RNA (U, C, A, G) và DNA (T, C, A, G, trong đó T tự đổi thành U); ký tự ngoài phạm vi sẽ hiện thông báo lỗi và ẩn kết quả cũ. Tuy nhiên, người dùng vẫn cần xác định đúng trình tự RNA và chiều đọc trước khi tra cứu.
Nhìn rõ tính thoái hóa của mã di truyền
Tra cứu ngược có giá trị khi cần trả lời câu hỏi “Axit amin này được mã hóa bởi những bộ ba nào?”. So với việc rà từng vùng trong bảng tĩnh, công cụ tự tập hợp đầy đủ các kết quả, giúp nhận ra sự khác biệt giữa axit amin chỉ có một codon và axit amin có nhiều codon đồng nghĩa.
Kết nối kiến thức di truyền với hóa sinh
Kết quả không dừng ở tên axit amin mà còn hiển thị nhóm tính chất cơ bản. Người học có thể liên hệ một thay đổi codon với khả năng thay đổi loại mạch bên, chẳng hạn từ nhóm axit sang nhóm không phân cực.
Độ chính xác của kết quả nằm trong phạm vi bảng mã di truyền chuẩn được lập trình. Công cụ không xác định tác động của đột biến lên chức năng protein và không thay thế các bảng mã đặc thù của ty thể hay những hệ sinh học có ngoại lệ.
Các tính năng nổi bật
- Bảng tổng hợp đủ 64 codon: trình bày theo nucleotide thứ nhất và thứ hai, mỗi vùng chứa bốn khả năng của nucleotide thứ ba.
- Chi tiết tương tác: di chuột hoặc nhấp vào một codon sẽ hiển thị bộ ba, tên đầy đủ, mã một chữ cái, nhóm tính chất và số bộ ba đồng nghĩa; nhấp còn đồng bộ lựa chọn sang phần tra cứu nhanh.
- Tra cứu xuôi: kết quả cập nhật ngay khi thay đổi lựa chọn hoặc gõ đủ bộ ba, không cần nhấn nút; kết quả còn liệt kê toàn bộ bộ ba đồng nghĩa.
- Tra cứu ngược: tìm toàn bộ codon tương ứng với một axit amin và đếm số kết quả.
- Nhận diện trường hợp đặc biệt: AUG được gắn nhãn mở đầu; UAA, UAG và UGA được nhận diện là STOP.
- Chú giải phân loại: cung cấp nhãn màu cho nhóm không phân cực, phân cực, axit, bazơ, mở đầu và kết thúc.
- Danh sách lựa chọn có sắp xếp: các mục tra cứu ngược được sắp theo tên đầy đủ, mục STOP đặt cuối danh sách.
- Tìm nhanh và lọc bảng: gõ codon, tên hoặc mã axit amin để lọc bảng tức thì; lọc theo nhóm tính chất; chuyển hiển thị bảng giữa RNA (U) và DNA (T).
- Giao diện thích ứng màn hình nhỏ: bảng có thể cuộn ngang, hai khối tra cứu chuyển sang bố cục một cột.
Kết quả tra cứu có nút sao chép để mang sang bài tập hoặc tài liệu. Logic tra cứu được thực hiện bằng JavaScript trong trình duyệt; mã xử lý không gửi yêu cầu tra cứu đến máy chủ.
Đối tượng sử dụng
- Học sinh trung học: học mã di truyền, phiên mã, dịch mã và giải bài tập xác định axit amin từ bộ ba.
- Sinh viên sinh học, y dược và công nghệ sinh học: ôn tập sinh học phân tử, hóa sinh và quan hệ giữa codon với axit amin.
- Giáo viên, giảng viên: minh họa trực quan tính thoái hóa của mã di truyền và sự phân nhóm axit amin.
- Người làm nội dung khoa học: đối chiếu nhanh ví dụ về bộ ba, ký hiệu axit amin và codon kết thúc.
- Người làm việc trong lĩnh vực sinh học phân tử: tham khảo nhanh các ánh xạ codon đơn lẻ theo bảng chuẩn.
Công cụ phù hợp từ trình độ nhập môn, miễn là người dùng hiểu sự khác nhau giữa DNA và RNA, cũng như cách đọc một bộ ba theo chiều 5′ → 3′. Những bài toán chuyên sâu như tối ưu codon, dự đoán khung đọc hoặc dịch mã trình tự dài cần công cụ chuyên dụng khác.
Nguyên lý hoạt động và công thức
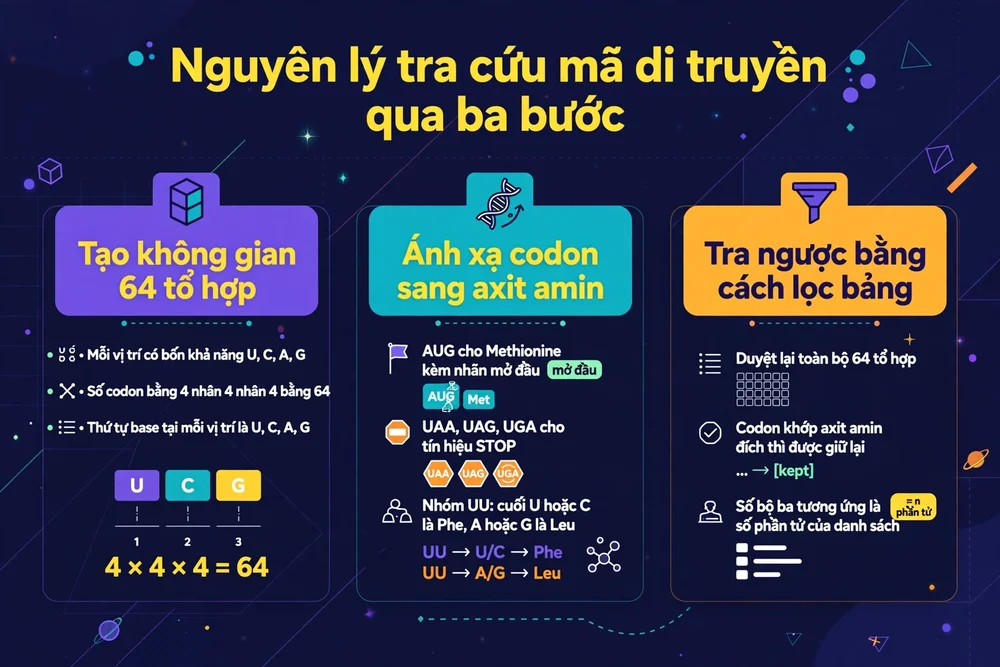
Tạo không gian 64 tổ hợp
Mỗi vị trí trong codon có bốn khả năng độc lập: U, C, A hoặc G. Số bộ ba được xác định bằng quy tắc nhân:
Số codon = 4 × 4 × 4 = 4³ = 64.
Thuật toán duyệt ba vị trí bằng ba vòng lặp lồng nhau. Thứ tự base tại mỗi vị trí là U, C, A, G. Mỗi tổ hợp được ghép thành một chuỗi ba ký tự và đưa qua cùng một hàm xác định axit amin.
Ánh xạ codon sang axit amin
Hàm tra cứu kiểm tra các trường hợp đặc biệt trước:
- AUG → Met: Methionine, kèm nhãn mã mở đầu.
- UAA, UAG, UGA → STOP: tín hiệu kết thúc theo bảng mã chuẩn.
Với các bộ ba còn lại, thuật toán phân nhánh theo nucleotide thứ nhất, rồi nucleotide thứ hai, và xét nucleotide thứ ba khi cần. Ví dụ:
- Bắt đầu bằng UU: nucleotide thứ ba là U hoặc C cho Phe; A hoặc G cho Leu.
- Bắt đầu bằng CC: cả bốn khả năng của nucleotide thứ ba đều cho Pro.
- Bắt đầu bằng AA: U hoặc C cho Asn; A hoặc G cho Lys.
- Bắt đầu bằng GG: cả bốn khả năng đều cho Gly.
Đây là phép ánh xạ dữ liệu sinh học, không phải công thức vật lý hay phép tính dự đoán. Có thể biểu diễn quan hệ dưới dạng: f(Nu 1, Nu 2, Nu 3) = axit amin hoặc STOP.
Tra cứu ngược bằng cách lọc toàn bộ bảng
Với một mục tiêu như Leu, công cụ duyệt lại 64 tổ hợp. Nếu kết quả ánh xạ của một codon trùng với Leu, codon đó được thêm vào danh sách kết quả. Cuối cùng, số phần tử của danh sách chính là số bộ ba tương ứng.
Ba chức năng — dựng bảng, tra xuôi và tra ngược — đều dùng chung một quy tắc ánh xạ. Cách tổ chức này giúp kết quả giữa các chế độ nhất quán. Mỗi lượt tra ngược chỉ kiểm tra 64 tổ hợp cố định, nên khối lượng xử lý nhỏ.
Phân biệt nhãn hiển thị với ngữ cảnh sinh học
Công cụ gắn AUG với “mã mở đầu” ở mọi lần tra cứu. Trong thực tế, AUG nằm bên trong vùng mã hóa vẫn có thể mã hóa Methionine mà không đóng vai trò khởi đầu; chức năng mở đầu phụ thuộc vị trí và ngữ cảnh của hệ dịch mã.
Tương tự, kết quả STOP được hiểu theo bảng mã chuẩn. Công cụ không xem xét tái mã hóa, tín hiệu điều hòa hay bảng mã thay thế.
Ví dụ thực tế
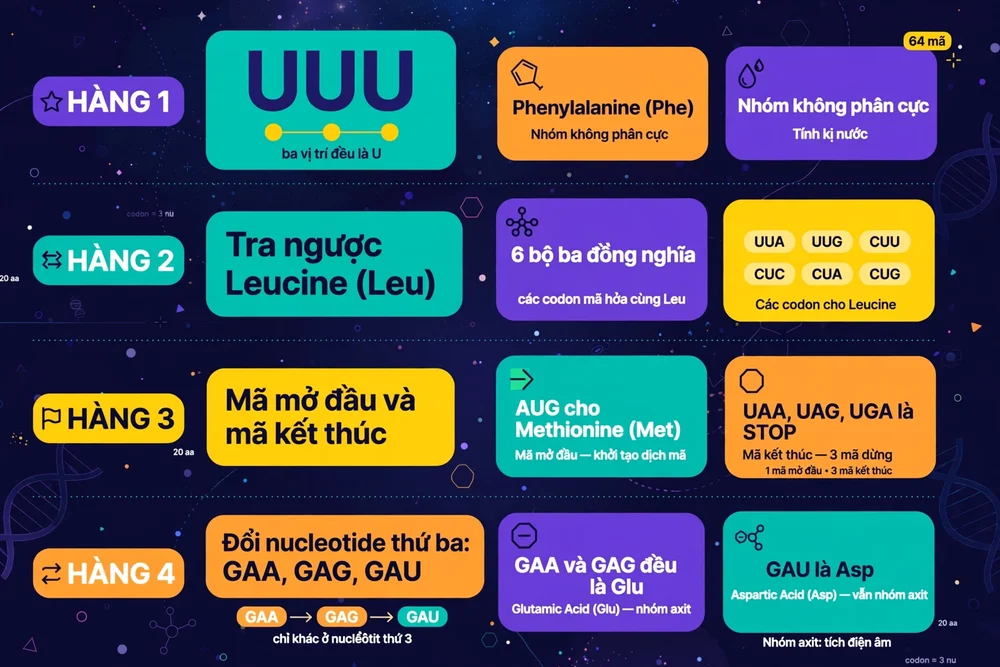
Ví dụ 1: Xác định axit amin từ UUU
Đầu vào: Nu 1 = U, Nu 2 = U, Nu 3 = U.
Kết quả: Phenylalanine, ký hiệu Phe, thuộc nhóm không phân cực trong dữ liệu công cụ.
Trường hợp này phù hợp để kiểm tra bài tập xác định sản phẩm mã hóa của một bộ ba mRNA. UUC cũng cho Phe, minh họa rằng thay đổi nucleotide thứ ba không phải lúc nào cũng làm đổi axit amin.
Ví dụ 2: Tìm các bộ ba mã hóa Leucine
Đầu vào: Leucine (Leu).
Kết quả: sáu bộ ba gồm UUA, UUG, CUU, CUC, CUA, CUG.
Kết quả cho thấy các codon đồng nghĩa không nhất thiết chỉ khác nucleotide thứ ba: các bộ ba mã hóa Leucine xuất hiện ở cả nhóm UU và CU.
Ví dụ 3: Nhận diện mã mở đầu và mã kết thúc
| Đầu vào | Kết quả | Ý nghĩa |
|---|---|---|
| AUG | Methionine (Met) | Được công cụ gắn nhãn mã mở đầu / không phân cực |
| UGA | STOP | Tín hiệu ngừng dịch mã theo bảng chuẩn |
| Tra ngược STOP | UAA, UAG, UGA | Ba bộ ba kết thúc, không mã hóa axit amin trong bảng chuẩn |
Ví dụ 4: Đối chiếu hai thay đổi ở nucleotide thứ ba
GAA → GAG: cả hai codon đều mã hóa Glutamic Acid (Glu), thuộc nhóm axit. Đây là thay đổi đồng nghĩa ở mức axit amin theo bảng chuẩn.
GAA → GAU: kết quả chuyển từ Glutamic Acid (Glu) sang Aspartic Acid (Asp). Axit amin thay đổi, dù cả hai vẫn thuộc nhóm axit trong cách phân loại của công cụ.
Ví dụ giúp phân biệt ba cấp độ: thay đổi nucleotide, thay đổi axit amin và thay đổi nhóm tính chất. Công cụ hỗ trợ đối chiếu hai cấp độ sau, nhưng không suy ra trực tiếp mức độ ảnh hưởng đến chức năng protein.
Những thông tin thú vị xung quanh chủ đề này
64 codon nhưng chỉ có 20 axit amin
Trong bảng mã chuẩn, 61 codon mã hóa axit amin và 3 codon là tín hiệu kết thúc. Vì nhiều codon cùng mã hóa một axit amin, mã di truyền được gọi là có tính thoái hóa. Thuật ngữ này không có nghĩa mã di truyền bị suy giảm chất lượng.
Số codon của từng axit amin không giống nhau
Methionine và Tryptophan mỗi loại có một codon: AUG và UGG. Leucine, Serine và Arginine mỗi loại có sáu codon. Sự phân bố không đồng đều này có thể quan sát trực tiếp qua kết quả tra cứu ngược.
Vị trí thứ ba thường linh hoạt, nhưng không phải luôn như vậy
Trong nhóm GGU, GGC, GGA và GGG, thay đổi nucleotide thứ ba vẫn giữ nguyên Glycine. Ngược lại, UGU và UGC mã hóa Cysteine, UGA là STOP, còn UGG mã hóa Tryptophan. Vì vậy, không thể mặc định mọi thay đổi ở vị trí thứ ba đều là thay đổi đồng nghĩa.
Mã di truyền gần như phổ biến, không tuyệt đối phổ biến
Bảng chuẩn áp dụng rộng rãi, nhưng một số hệ sinh học có cách diễn giải codon khác. Chẳng hạn, trong mã di truyền ty thể người, UGA mã hóa Tryptophan thay vì STOP. Đây là lý do cần biết nguồn gốc trình tự trước khi áp dụng kết quả tra cứu.
Tra cứu ngược không khôi phục duy nhất trình tự gene
Một axit amin có thể tương ứng với nhiều codon, nên biết chuỗi protein chưa đủ để xác định duy nhất chuỗi nucleotide ban đầu. Tra cứu ngược cho biết các khả năng mã hóa, không cho biết codon nào thực sự đã được sử dụng trong một gene cụ thể.
Những câu hỏi thường gặp
Công cụ sử dụng bộ ba DNA hay RNA?
Công cụ sử dụng bộ ba RNA với U, C, A và G. Nếu dữ liệu là mạch mã hóa DNA viết theo chiều 5′ → 3′, bộ ba RNA tương ứng có cùng trình tự base nhưng thay T bằng U. Nếu là mạch khuôn, cần xác định trình tự bổ sung và chiều đọc; không thể chỉ thay T bằng U.
STOP có phải axit amin thứ 21 không?
Không. STOP là một mục tra cứu dành cho tín hiệu kết thúc. Danh sách có 21 lựa chọn nhưng chỉ gồm 20 axit amin và một nhóm STOP.
Tại sao một axit amin có nhiều bộ ba?
Đó là tính thoái hóa của mã di truyền. Các bộ ba khác nhau có thể cùng mã hóa một axit amin; công cụ tra cứu ngược liệt kê đầy đủ những bộ ba này theo bảng chuẩn.
AUG có luôn là vị trí bắt đầu dịch mã không?
Không. AUG được công cụ đánh dấu là mã mở đầu, nhưng vai trò khởi đầu trong sinh học phụ thuộc ngữ cảnh. AUG nằm trong vùng mã hóa thường biểu thị Methionine ở vị trí bên trong chuỗi protein.
Công cụ có dịch được cả chuỗi mRNA không?
Không. Mã nguồn hiện tại xử lý một codon trong mỗi lần tra xuôi và tập hợp codon cho một mục trong mỗi lần tra ngược. Công cụ không xác định khung đọc, tìm vùng mã hóa hay dịch tự động một chuỗi dài.
Nhóm axit, bazơ và phân cực có phải kết quả tính toán hóa học không?
Không. Đây là các nhãn phân loại có sẵn trong dữ liệu. Công cụ không nhận pH, không tính pKa, điểm đẳng điện, khối lượng phân tử hoặc điện tích của protein.
Có thể dùng kết quả để kết luận một đột biến là có hại không?
Không. Kết quả giúp xác định codon mới có đổi axit amin hoặc tạo STOP theo bảng chuẩn hay không. Đánh giá tác động sinh học còn cần thông tin về vị trí biến đổi, cấu trúc, chức năng protein và bối cảnh tế bào.
Kết quả có áp dụng cho trình tự ty thể không?
Không nên áp dụng mặc định. Công cụ dùng bảng mã chuẩn và không có lựa chọn bảng mã ty thể. Với trình tự có mã di truyền khác chuẩn, cần đối chiếu bảng mã phù hợp với sinh vật và bào quan.