
Máy tính thống kê là gì?
Máy tính thống kê là công cụ tính các đại lượng thống kê mô tả từ một danh sách quan sát dạng số. Thống kê mô tả giúp thu gọn nhiều giá trị thành những chỉ tiêu dễ đọc, cho biết dữ liệu có bao nhiêu quan sát, tập trung quanh mức nào và phân tán ra sao. Đây không phải một hệ thống phân tích thống kê toàn diện hay công cụ tự đưa ra kết luận về nguyên nhân.
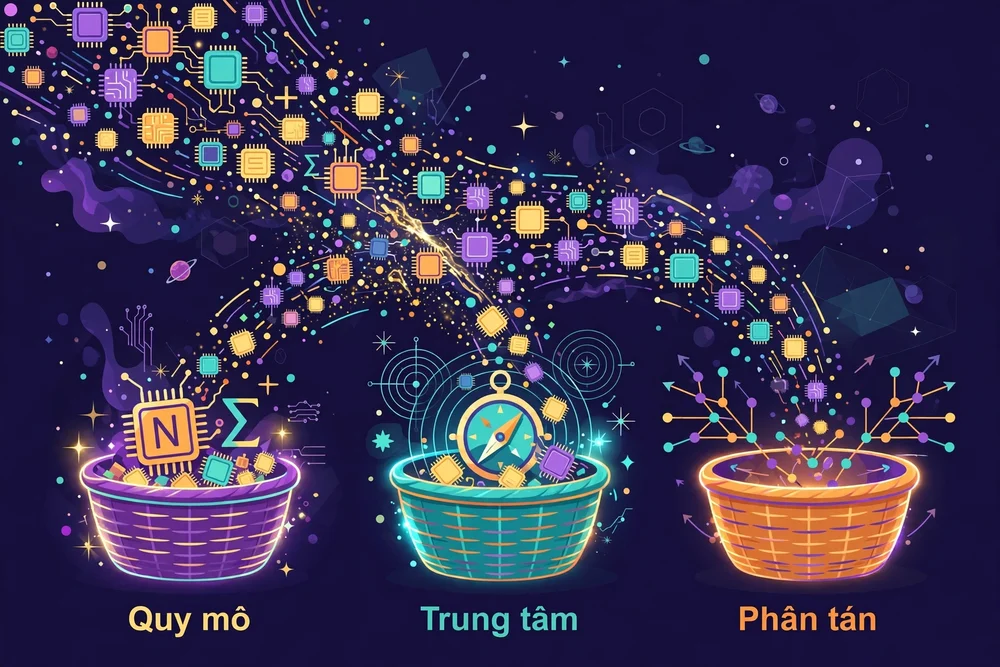
Công cụ trả về ba nhóm thông tin. Nhóm quy mô gồm số lượng quan sát và tổng. Nhóm vị trí trung tâm gồm trung bình cộng, trung vị và yếu vị. Nhóm phân tán gồm giá trị nhỏ nhất, lớn nhất, khoảng biến thiên, cùng phương sai và độ lệch chuẩn theo cách tính mẫu và quần thể. Trong mục chi tiết còn có tứ phân vị Q1, Q3, khoảng tứ phân vị IQR, dãy đã sắp xếp và tổng bình phương độ lệch; kết quả có thể sao chép hoặc tải file txt.
Công cụ phù hợp với người học muốn đối chiếu bài tính, người cần tóm tắt một danh sách phép đo hoặc các thời gian hoàn thành công việc. Kết quả giúp nhìn nhanh đặc điểm dữ liệu, nhưng không tự chứng minh chất lượng phép đo, tính đại diện của mẫu hay sự khác biệt có ý nghĩa thống kê. Xem thêm các công cụ khác trong danh mục Toán học để chọn đúng tiện ích cho từng dạng bài.
Phạm vi được xác nhận là danh sách số riêng lẻ. Không có căn cứ để xem đây là chế độ xử lý trực tiếp số liệu ghép nhóm, hoặc hướng dẫn thao tác trên máy tính cầm tay 570, 880. Những nhu cầu đó cần phương pháp hoặc tài liệu riêng.
Dữ liệu đầu vào và cách hiểu các kết quả
Danh sách số nào được công cụ tiếp nhận?
Công cụ tính trực tiếp ngay khi bạn gõ, không cần bấm nút tính. Công cụ nhận số nguyên, số âm và số thập phân, cùng ký pháp khoa học. Ở chế độ “Chấm (.)” mặc định, dấu chấm là thập phân và các giá trị ngăn cách bằng dấu phẩy, dấu chấm phẩy, khoảng trắng, tab hoặc xuống dòng. Ở chế độ “Phẩy VN (,)”, dấu phẩy là thập phân và các giá trị ngăn cách bằng dấu chấm phẩy, khoảng trắng hoặc xuống dòng. Độ chính xác và cách hiển thị với giá trị quá lớn hoặc quá nhỏ có giới hạn.
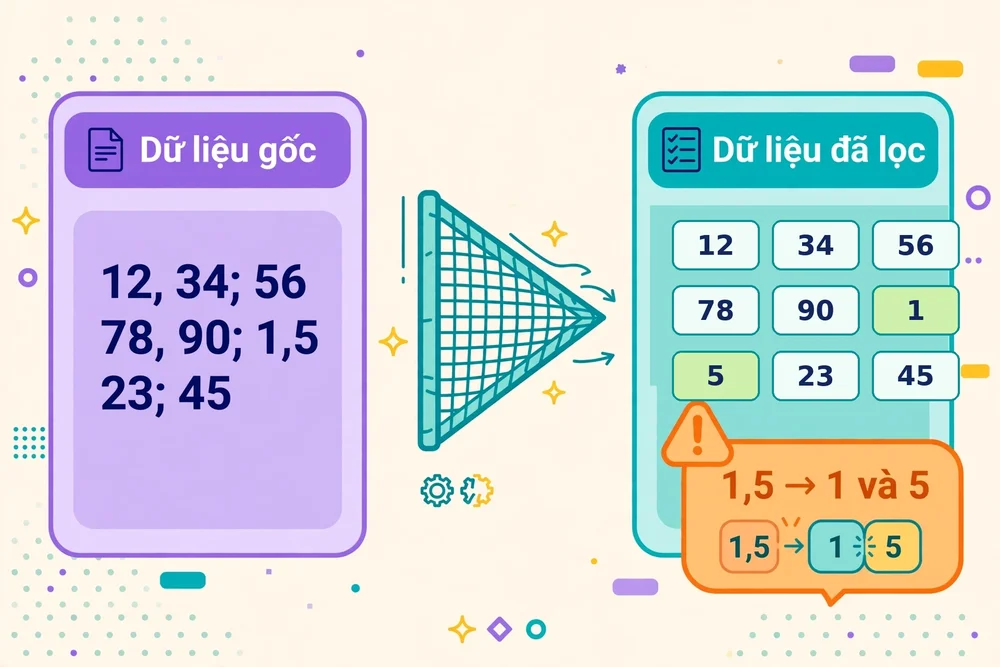
Ở chế độ “Chấm (.)” mặc định, dấu phẩy được hiểu là dấu phân tách, không phải dấu thập phân. Vì vậy, 1,5 tạo thành hai quan sát 1 và 5, thay vì số 1.5. Muốn viết số thập phân kiểu Việt Nam, hãy chuyển sang chế độ “Phẩy VN (,)” rồi viết 1,5; 2,5 để được hai số 1,5 và 2,5. Dấu phân nhóm hàng nghìn cũng có thể làm thay đổi dữ liệu. Khi dán từ bảng tính, hãy dùng các giá trị cùng đại lượng, cùng đơn vị và kiểm tra định dạng số.
Dòng “Dãy đã nhận” cho biết những số thực sự được tiếp nhận, giữ thứ tự nhập và giữ các lần lặp, kèm số lượng N. Đây là điểm đối chiếu quan trọng: số lượng có đúng không, có số bị tách thành nhiều phần không? Bộ đọc số của bản mới rất nghiêm ngặt: mỗi token phải khớp trọn vẹn một số hợp lệ, nếu không token đó được liệt kê tên trong thông báo lỗi và kết quả bị ẩn, thay vì bị cắt xén hay bỏ qua lặng lẽ. Công cụ không có ô quản lý đơn vị hoặc tần số riêng.
Các ô kết quả nói lên điều gì?
| Đầu ra | Ý nghĩa |
|---|---|
| Số lượng N | Số quan sát được nhận, tính cả giá trị lặp. |
| Tổng | Tổng của tất cả quan sát. |
| Trung bình cộng | Tổng chia cho số quan sát. |
| Trung vị | Mức giữa của danh sách đã sắp thứ tự. |
| Yếu vị | Giá trị xuất hiện nhiều nhất theo quy ước của công cụ. |
| Nhỏ nhất | Quan sát có giá trị thấp nhất. |
| Lớn nhất | Quan sát có giá trị cao nhất. |
| Khoảng biến thiên | Hiệu giữa lớn nhất và nhỏ nhất. |
| Phương sai mẫu | Mức phân tán tính với mẫu số N − 1. |
| Phương sai quần thể | Mức phân tán tính với mẫu số N. |
| Độ lệch chuẩn mẫu | Căn bậc hai của phương sai mẫu. |
| Độ lệch chuẩn quần thể | Căn bậc hai của phương sai quần thể. |
| Tứ phân vị Q1, Q3, IQR (mục chi tiết) | Q1 và Q3 tính theo Tukey hinges: trung vị của nửa dưới và nửa trên, khi N lẻ thì loại trung vị khỏi cả hai nửa; IQR = Q3 − Q1. |
Nếu dữ liệu đo bằng cm, các chỉ tiêu trung tâm, cực trị, khoảng biến thiên và độ lệch chuẩn được hiểu theo cm; phương sai theo cm². Công cụ chỉ hiển thị số, không tự gắn đơn vị. Kết quả cập nhật trực tiếp khi bạn gõ; khi nhập dữ liệu không hợp lệ hoặc rỗng, công cụ hiện thông báo lỗi và ẩn kết quả, không giữ kết quả cũ. Nút “Làm mới” đưa ô nhập về dãy ví dụ mặc định 2, 4, 4, 6.
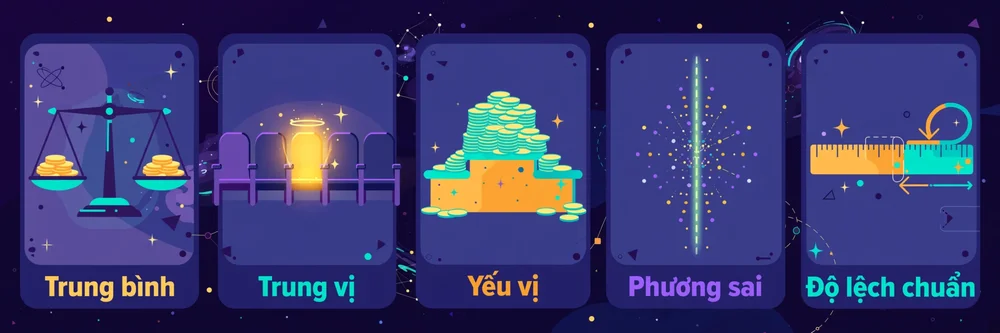
Năm thuật ngữ thống kê cần hiểu khi đọc kết quả
Trung bình cộng
Trung bình cộng là tổng các quan sát chia cho số quan sát, biểu thị mức nhận được nếu chia đều tổng. Trong công cụ, đây vừa là kết quả mô tả vị trí trung tâm, vừa là mốc để tính độ phân tán. Theo kiến thức thống kê chung, một giá trị rất lớn hoặc rất nhỏ có thể kéo trung bình lệch đáng kể. Vì thế, “trung bình” không nhất thiết là giá trị phổ biến nhất, cũng không bắt buộc xuất hiện trong danh sách gốc. Với các phép cộng, trừ, nhân, chia trong bước tính tổng, bạn có thể đối chiếu từng bước bằng máy tính phép tính cộng, trừ, nhân, chia có giải thích.
Trung vị
Trung vị là giá trị giữa khi các quan sát đã được sắp theo thứ tự. Nếu số quan sát chẵn, nó là trung bình của hai giá trị giữa. Chỉ tiêu này mô tả trung tâm theo vị trí, khác với cách chia đều tổng của trung bình cộng. Điểm dễ nhầm là lấy số nằm giữa thứ tự nhập: công cụ phải sắp tăng dần trước khi xác định trung vị. Với dữ liệu có giá trị cực đoan, trung vị thường ít bị kéo lệch hơn trung bình.
Yếu vị (mốt)
Yếu vị, còn gọi là mốt, là giá trị có tần suất xuất hiện cao nhất. Tần suất ở đây là số lần một giá trị có mặt trong danh sách, không phải độ lớn của nó. Có thể có nhiều giá trị đồng hạng. Công cụ chỉ báo không có yếu vị khi có từ hai giá trị phân biệt trở lên mà mọi giá trị phân biệt đều có cùng tần suất; dãy chỉ có một giá trị phân biệt thì yếu vị chính là giá trị đó. Khi cần biểu diễn tần suất dưới dạng tỷ lệ, bạn có thể dùng máy tính tỷ lệ phần trăm để đổi nhanh sang phần trăm.
Phương sai
Phương sai tổng hợp các bình phương độ lệch của quan sát so với trung bình, dùng để mô tả mức phân tán. Các quan sát càng cách xa trung bình thì phần đóng góp vào phương sai càng lớn. Công cụ hiển thị riêng phương sai mẫu và quần thể. Điểm quan trọng khi diễn giải là đơn vị bị bình phương: dữ liệu đo bằng g thì phương sai có đơn vị g². Không nên đọc phương sai như một khoảng cách trực tiếp hay nhầm nó với khoảng biến thiên.
Độ lệch chuẩn
Độ lệch chuẩn là căn bậc hai của phương sai, đưa mức phân tán trở về cùng thang đơn vị với dữ liệu. Nhờ đó, người dùng dễ so sánh độ phân tán với mức trung bình của một danh sách phép đo. Công cụ cung cấp hai kết quả tương ứng với phương sai mẫu và quần thể. Độ lệch chuẩn không phải độ lệch lớn nhất, cũng không phải giới hạn chắc chắn chứa mọi quan sát. Chỉ từ chỉ tiêu này không thể kết luận dữ liệu tuân theo một phân phối cụ thể.
Công cụ tính các đại lượng thống kê như thế nào?
Từ danh sách quan sát đến các chỉ tiêu trung tâm
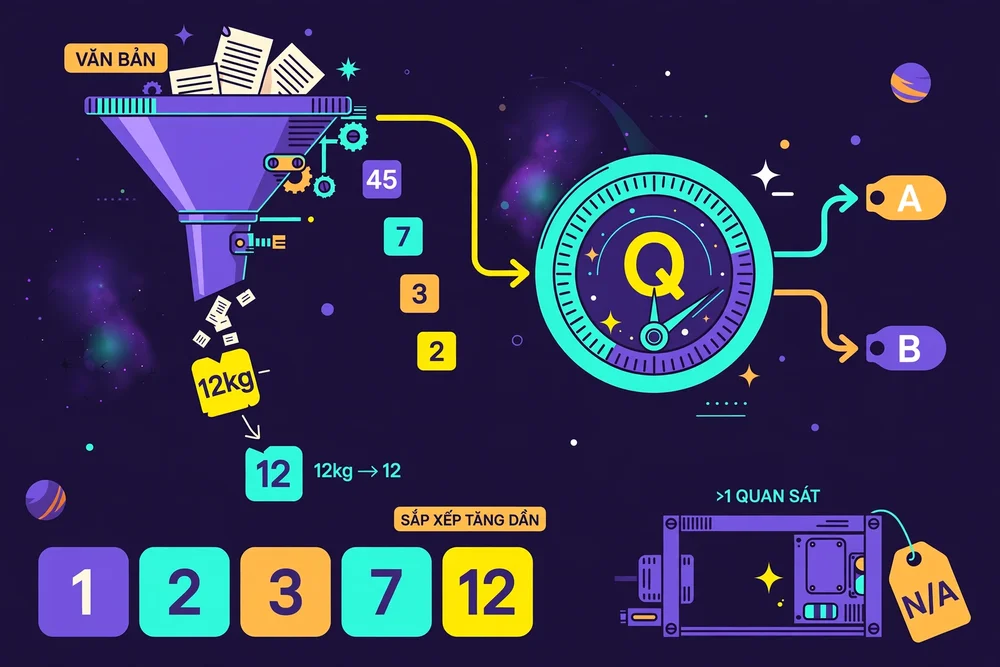
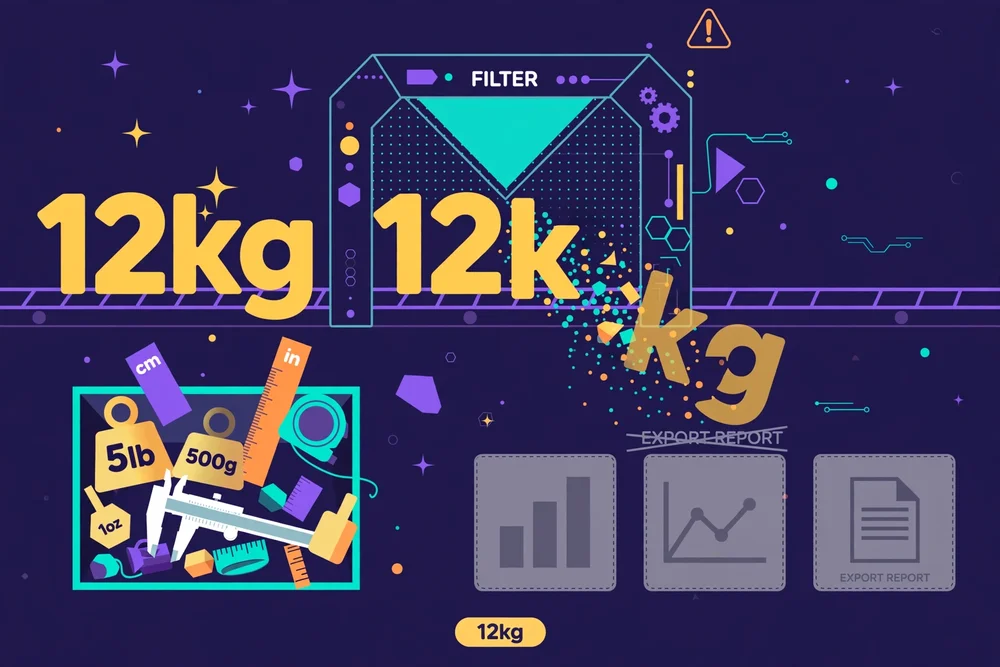
Công cụ thay các dấu phân tách được hỗ trợ bằng khoảng trắng, tách văn bản rồi đọc từng phần thành số. Bộ đọc số rất nghiêm ngặt: mỗi token phải khớp trọn vẹn một số hợp lệ; chẳng hạn 12kg hay abc được liệt kê tên trong thông báo lỗi và kết quả bị ẩn, thay vì được nhận một phần hay bỏ qua lặng lẽ. Sau đó, mỗi số được nhận đều được tính là một quan sát.
Tổng bằng Σxᵢ và trung bình x̄ = Σxᵢ/N. Một bản sao của danh sách được sắp tăng dần để lấy nhỏ nhất, lớn nhất và trung vị, không đổi thứ tự danh sách dữ liệu hiển thị. Nếu N lẻ, trung vị là quan sát chính giữa; nếu N chẵn, lấy trung bình hai quan sát giữa. Với những phép tính gộp nhiều bước ngoài thống kê mô tả, máy tính khoa học trực tuyến tính được cả biểu thức phức tạp trong một lần nhập.
Để tìm yếu vị, công cụ đếm số lần xuất hiện của từng giá trị. Nếu một hoặc nhiều giá trị cùng có tần suất cao nhất, chúng được liệt kê, trừ trường hợp có từ hai giá trị phân biệt trở lên mà mọi giá trị phân biệt đều có tần suất bằng nhau. Khi đó công cụ báo “Không có”. Dãy chỉ có một giá trị phân biệt thì yếu vị chính là giá trị đó.
Cách tính mức phân tán
Khoảng biến thiên bằng lớn nhất − nhỏ nhất. Với phương sai, công cụ trước hết tính tổng bình phương độ lệch: Q = Σ(xᵢ − x̄)². Phương sai quần thể là σ² = Q/N; phương sai mẫu là s² = Q/(N − 1). Độ lệch chuẩn tương ứng là σ = √σ² và s = √s².
Hai chỉ tiêu mẫu chỉ được hiển thị khi N > 1. Với một quan sát, độ lệch so với trung bình bằng 0 nên phương sai và độ lệch chuẩn quần thể bằng 0. Tuy nhiên, hai chỉ tiêu mẫu được ghi “— (cần N > 1)” kèm câu giải thích rằng công thức mẫu chia cho N − 1 = 0, không được trình bày như kết quả bằng 0.
Quy tắc hiển thị và làm tròn
Các phép tính dùng giá trị chưa làm tròn. Bước làm tròn diễn ra khi hiển thị, thông thường đến tối đa năm chữ số thập phân và không thêm số 0 cho đủ năm chữ số; các số hiển thị dùng định dạng Việt Nam (dấu phẩy thập phân). Token cho ra giá trị không hữu hạn bị liệt kê tên trong thông báo lỗi và không được tính. Cách hiển thị này có giới hạn với một số giá trị biểu diễn bằng ký pháp khoa học; không nên xem đó là bảo đảm chính xác cho mọi độ lớn đầu vào.
Phân biệt thống kê mẫu, quần thể và số liệu ghép nhóm
Khi nào đọc kết quả mẫu hoặc quần thể?
Trong kiến thức thống kê chung, quần thể là toàn bộ tập đối tượng đang được xét; mẫu là một phần được dùng để tìm hiểu tập lớn hơn. Cùng một danh sách có thể đóng vai trò khác nhau tùy câu hỏi. Nếu đã ghi nhận toàn bộ các lần đo cần mô tả, cách tính quần thể có thể phù hợp. Nếu dùng những lần đo đó để ước lượng biến động của một tập lớn hơn, cách tính mẫu thường được xem xét.
Mẫu số N − 1 là hiệu chỉnh quen thuộc khi ước lượng phương sai quần thể từ mẫu trong điều kiện thống kê phù hợp. Công cụ không tự kiểm tra điều kiện lấy mẫu. Với cùng dữ liệu có N > 1 và Q > 0, phương sai mẫu lớn hơn phương sai quần thể; nếu mọi quan sát giống nhau, cả hai bằng 0.
Vì sao bảng ghép nhóm không tương đương danh sách số?
Danh sách riêng lẻ chứa từng quan sát. Bảng tần số chứa giá trị và số lần xuất hiện. Bảng ghép nhóm theo khoảng chỉ cho biết bao nhiêu quan sát nằm trong từng lớp, không giữ đầy đủ giá trị gốc. Công cụ hiện chỉ có đầu vào cho danh sách riêng lẻ; dán hai cột giá trị và tần số sẽ khiến các số trong cả hai cột bị xem là những quan sát độc lập.
Với bảng tần số rời rạc đơn giản, có thể chuẩn bị danh sách bằng cách lặp từng giá trị đúng số lần. Với dữ liệu theo khoảng, dùng trung điểm lớp là phương pháp xấp xỉ thuộc kiến thức nền, không khôi phục chính xác dữ liệu gốc và không phải chế độ ghép nhóm được công cụ cung cấp. Mã cũng không xác nhận chuỗi phím thao tác trên máy tính cầm tay.
Ví dụ tính thống kê và diễn giải kết quả
Danh sách khối lượng có một yếu vị
Giả sử có bốn khối lượng 2, 4, 4, 6 g. Các kết quả dưới đây được tính theo công thức của công cụ. Đơn vị được bổ sung để giải thích, không phải nhãn do công cụ tự hiển thị.
| Chỉ tiêu | Kết quả |
|---|---|
| Số lượng; tổng | 4 quan sát; 16 g |
| Trung bình; trung vị; yếu vị | 4 g; 4 g; 4 g |
| Nhỏ nhất; lớn nhất; khoảng biến thiên | 2 g; 6 g; 4 g |
| Phương sai quần thể; mẫu | 2 g²; 2,66667 g² |
| Độ lệch chuẩn quần thể; mẫu | 1,41421 g; 1,63299 g |
Trung bình và trung vị cùng bằng 4 g nhưng không có nghĩa mọi khối lượng đều bằng 4 g. Hai quan sát ở hai phía vẫn tạo ra phân tán. Tổng bình phương độ lệch là 8 g², cho phép đối chiếu sự khác nhau giữa hai cách tính phương sai.
Danh sách thời gian có hai yếu vị
Giả sử năm thời gian hoàn thành là 1, 1, 2, 2, 4 phút. Tổng bằng 10 phút, trung bình bằng 2 phút và trung vị bằng 2 phút. Vì N lẻ, trung vị là quan sát thứ ba sau khi sắp thứ tự.
| Chỉ tiêu | Kết quả |
|---|---|
| Yếu vị | 1 và 2 phút |
| Khoảng biến thiên | 3 phút |
| Phương sai quần thể; mẫu | 1,2 phút²; 1,5 phút² |
| Độ lệch chuẩn quần thể; mẫu | 1,09545 phút; 1,22474 phút |
Hai giá trị 1 và 2 đều xuất hiện hai lần, còn 4 chỉ xuất hiện một lần. Vì vậy, có hai yếu vị đồng hạng và không rơi vào trường hợp tất cả tần suất bằng nhau.
Các trường hợp biên và lỗi dấu thập phân
Với bốn chiều dài 1, 1, 2, 2 cm, trung bình và trung vị đều bằng 1,5 cm, nhưng công cụ báo không có yếu vị. Lý do là hai giá trị phân biệt cùng xuất hiện hai lần, khác với ví dụ thời gian còn có một giá trị tần suất thấp hơn.
Nếu chỉ có một nhiệt độ 7 °C, trung bình, trung vị, nhỏ nhất và lớn nhất đều bằng 7 °C. Khoảng biến thiên và hai chỉ tiêu phân tán quần thể bằng 0; hai chỉ tiêu mẫu hiển thị “— (cần N > 1)”. Một phép đo như vậy không đủ để đánh giá biến động nhiệt độ thực tế.
Nếu định nhập hai chiều dài 1.5 và 2.5 cm nhưng viết 1,5; 2,5 ở chế độ “Chấm (.)” mặc định, công cụ nhận 1, 5, 2, 5. Khi đó N = 4, trung bình = 3,25, trung vị = 3,5 và yếu vị = 5. Kết quả đúng với danh sách được nhận, nhưng sai với ý định ban đầu. Chuyển sang chế độ “Phẩy VN (,)” thì cùng dãy đó được nhận đúng là hai số 1,5 và 2,5.
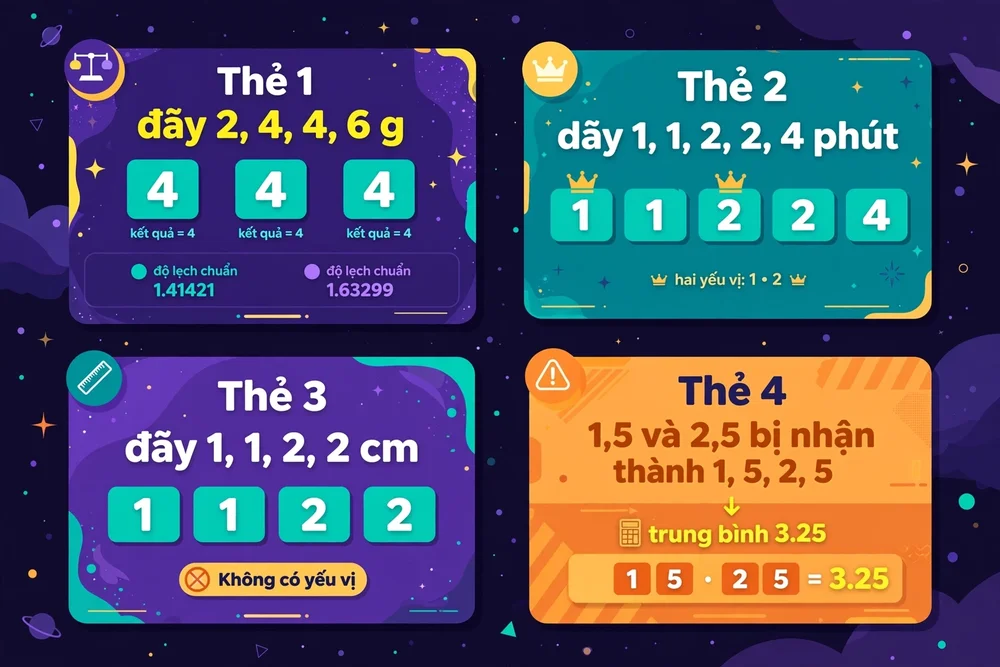 Viết 1,5 và 2,5 sẽ bị nhận thành 1, 5, 2, 5 — trung bình thành 3,25 thay vì 2.
Ứng dụng kết quả thống kê trong học tập và công việc
Trong học tập, công cụ có thể dùng để đối chiếu bài tính trên dữ liệu riêng lẻ. Việc nhìn đồng thời phương sai mẫu và quần thể giúp nhận ra sai khác do chọn mẫu số, thay vì vội cho rằng một kết quả tính tay hoặc máy tính cầm tay đã sai. Người học vẫn cần xác định đề bài đang yêu cầu đại lượng nào.
Với thời gian hoàn thành công việc hoặc các phép đo cùng đơn vị, trung bình và trung vị giúp đọc mức điển hình; độ lệch chuẩn giúp mô tả độ ổn định. Hai danh sách có trung bình gần nhau vẫn có thể phân tán khác nhau, nên chỉ nhìn một ô kết quả sẽ bỏ sót thông tin.
Khi so sánh hai danh sách cùng đại lượng, hãy đọc cùng lúc số lượng quan sát, mức trung tâm và mức phân tán. Đồng thời xem các dữ liệu có được thu thập trong điều kiện tương đương hay không. Các chỉ tiêu này không đủ để khẳng định khác biệt có ý nghĩa thống kê.
Nếu trung bình và trung vị cách xa nhau hoặc khoảng biến thiên lớn, nên kiểm tra dữ liệu gốc để tìm lỗi ghi chép hoặc giá trị bất thường. Đây là việc người dùng cần thực hiện, không phải chức năng tự phát hiện ngoại lệ. Thống kê mô tả cũng không chứng minh nguyên nhân hay bảo đảm dự đoán tương lai. Bạn có thể khám phá thêm nhiều tiện ích tính toán miễn phí khác trên congcuviet.com.
Giới hạn và những lưu ý để tránh đọc sai kết quả
Bộ đọc số nghiêm ngặt không đồng nghĩa kiểm tra dữ liệu hoàn chỉnh. Token phải khớp trọn vẹn một số hợp lệ; token như 12kg hay abc được liệt kê tên trong thông báo lỗi và kết quả bị ẩn, thay vì bị cắt xén hay bỏ qua lặng lẽ. Nhờ vậy, một kết quả hiển thị luôn tương ứng với đúng dãy đã nhận, nhưng bạn vẫn cần đối chiếu dãy đó với ý định ban đầu.
Công cụ không kiểm tra sự thống nhất đơn vị, độ tin cậy của phép đo hoặc tính đại diện của mẫu. Trộn các đại lượng khác nhau vẫn có thể tạo kết quả số nhưng không tạo ra diễn giải thống kê có ý nghĩa. Công cụ cũng không có chức năng tải tệp bảng tính, biểu đồ hay kiểm định; tứ phân vị Q1, Q3, IQR có trong mục chi tiết, còn kết quả có thể sao chép hoặc tải file txt.
Các phép tính sử dụng số dấu phẩy động, vốn có giới hạn độ chính xác. Giá trị cực lớn hoặc cực nhỏ có thể làm kết quả và bước làm tròn không đáng tin cậy; token cho ra giá trị không hữu hạn bị liệt kê tên trong thông báo lỗi và không được tính. Công cụ không công bố ngưỡng đầu vào an toàn.
Không có căn cứ xác nhận dung lượng xử lý tối đa, hiệu năng hoặc chính sách truyền và lưu dữ liệu của toàn website. Mô tả ở đây dựa trên công cụ, không phải kiểm thử trang thực tế; các thành phần khác của website chưa được xác minh.
Câu hỏi thường gặp
Tôi có thể dùng dấu phẩy để nhập số thập phân không?
Được, nếu bạn chuyển sang chế độ “Phẩy VN (,)”: khi đó dấu phẩy là thập phân và các số ngăn cách bằng dấu chấm phẩy, khoảng trắng hoặc xuống dòng, ví dụ 1,5; 2,5 là hai số 1,5 và 2,5. Ở chế độ “Chấm (.)” mặc định thì không: dấu phẩy dùng để phân tách các quan sát, nên số một phẩy năm phải viết thành 1.5; viết 1,5 sẽ thành hai quan sát riêng biệt. Cũng cần tránh dấu phẩy phân nhóm hàng nghìn. Trước khi diễn giải kết quả, hãy đối chiếu “Dãy đã nhận” với các giá trị bạn định nhập.
Dán một cột số từ Excel vào công cụ có được không?
Có, bạn có thể dán một cột giá trị số dưới dạng văn bản vì công cụ nhận dấu xuống dòng và tab làm dấu phân tách. Tuy nhiên, đây không phải chức năng đọc tệp Excel hay hiểu cấu trúc bảng tính. Nếu vùng sao chép chứa nhiều cột, tiêu đề hoặc đơn vị, các token đó được liệt kê tên trong thông báo lỗi và kết quả bị ẩn, thay vì bị bỏ qua lặng lẽ. Số dùng dấu phẩy thập phân cần chuyển sang chế độ “Phẩy VN (,)” trước khi dán. Hãy kiểm tra “Dãy đã nhận” và bảo đảm mọi quan sát cùng đại lượng, cùng đơn vị.
Nên dùng phương sai mẫu hay phương sai quần thể?
Hãy chọn theo phạm vi bạn muốn mô tả và mục đích sử dụng dữ liệu. Phương sai quần thể phù hợp khi danh sách là toàn bộ tập đang xét; phương sai mẫu thường được dùng khi danh sách là mẫu để ước lượng phương sai của tập lớn hơn trong bối cảnh phù hợp. Công cụ hiển thị cả hai nhưng không tự quyết định thay bạn. Với bài tập, hãy theo quy ước của đề; với dữ liệu thực tế, cần xét cả cách lấy mẫu và câu hỏi nghiên cứu.
Dãy toàn số giống nhau thì yếu vị là gì?
Yếu vị chính là giá trị duy nhất đó. Bản mới chỉ báo “Không có” khi có từ hai giá trị phân biệt trở lên mà mọi giá trị phân biệt đều có cùng tần suất, ví dụ 1, 1, 2, 2. Quy ước cũ từng báo không có yếu vị cả với dãy toàn số giống nhau; bản mới đã sửa điểm này, nhưng bạn vẫn nên đối chiếu quy ước với tài liệu học trước khi dùng kết quả cho bài học.
Vì sao phương sai mẫu và độ lệch chuẩn mẫu hiển thị “— (cần N > 1)”?
Hai chỉ tiêu mẫu hiển thị “— (cần N > 1)” khi công cụ chỉ tiếp nhận một quan sát. Công thức phương sai mẫu dùng mẫu số N − 1, nên với N = 1 không thể áp dụng cách tính đó. Bạn cần kiểm tra “Dãy đã nhận”, vì token lỗi cũng có thể khiến danh sách còn một số. Trong trường hợp này, các chỉ tiêu quần thể vẫn có thể bằng 0, nhưng không thể dùng số 0 ấy để kết luận tập đối tượng lớn hơn không có biến động.
Công cụ có tính trực tiếp mẫu số liệu ghép nhóm không?
Không có chế độ tính trực tiếp bảng số liệu ghép nhóm trong công cụ. Công cụ không có ô nhập khoảng lớp và tần số, cũng không tự hiểu quan hệ giữa hai cột. Dán cận lớp, trung điểm và tần số vào chung sẽ khiến chúng bị coi là các quan sát riêng. Với bảng tần số giá trị rời rạc, có thể chuẩn bị danh sách bằng cách lặp giá trị; với khoảng lớp, dùng trung điểm chỉ là xấp xỉ, không tương đương dữ liệu gốc.
Nhập dữ liệu không hợp lệ thì công cụ phản hồi ra sao?
Bản mới không giữ kết quả cũ. Khi có token không phải số hợp lệ, công cụ liệt kê đúng token đó trong thông báo lỗi và ẩn toàn bộ kết quả; khi ô nhập rỗng, công cụ yêu cầu nhập ít nhất một số. Sửa hoặc xóa token lỗi thì kết quả tính lại trực tiếp. Nút “Làm mới” đưa ô nhập về dãy ví dụ mặc định 2, 4, 4, 6, chứ không để lại các số 0 như kết quả thống kê.
Tài liệu tham khảo
- Thống kê mô tả — Nguồn: https://vi.wikipedia.org/wiki/Thống_kê_mô_tả
- Phương sai — Nguồn: https://vi.wikipedia.org/wiki/Phương_sai
- Độ lệch chuẩn — Nguồn: https://vi.wikipedia.org/wiki/Độ_lệch_chuẩn
- Tứ phân vị — Nguồn: https://vi.wikipedia.org/wiki/Tứ_phân_vị
- Mã nguồn công cụ statistics-calculator-v2.js trên congcuviet.com (đối chiếu trực tiếp hành vi công cụ, chạy thử bằng Node.js) — Nguồn: https://congcuviet.com/cong-cu/may-tinh-thong-ke-statistics-calculator/


